A discussão sobre inteligência artificial e segurança costuma se concentrar no atacante mais sofisticado. É a metade menos urgente da história.
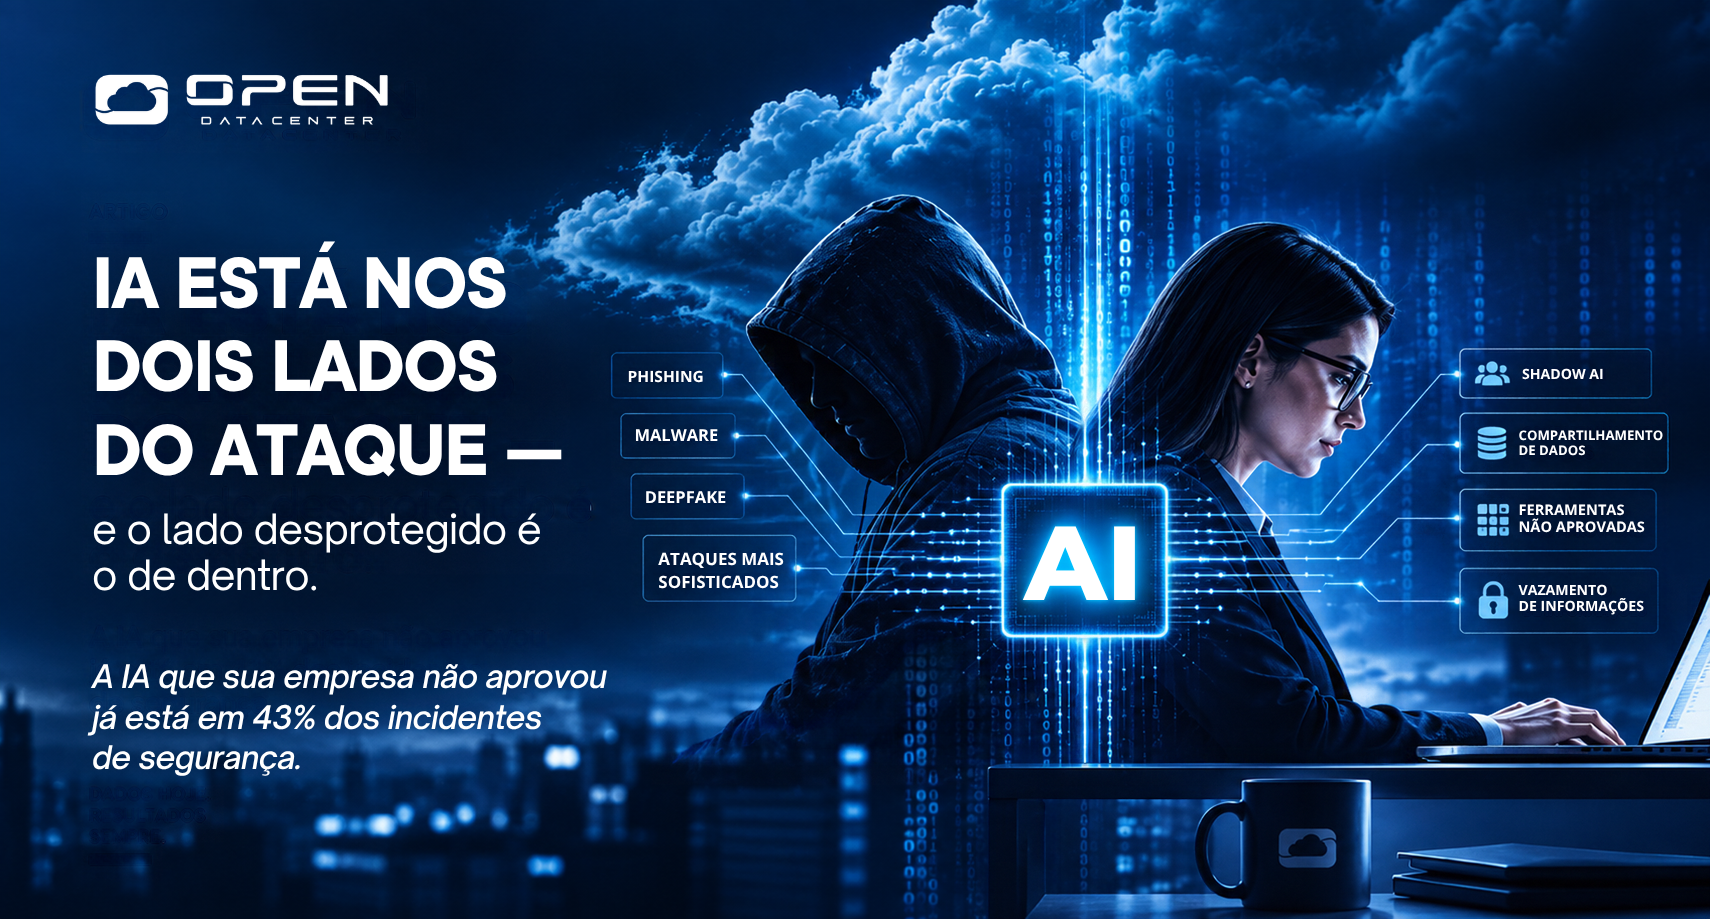
A resposta curta para quem chegou aqui procurando: o risco de IA mais custoso hoje não é o ataque gerado por IA — é a IA que a própria empresa usa sem governança. Ferramentas não aprovadas apareceram em 43% dos incidentes de segurança em 2026, mais que o dobro da participação do ano anterior.
O que os dados mostram
O relatório Cost of a Data Breach 2026, da IBM, traz três recortes que mudam a leitura do tema.
Primeiro — a IA já está no ataque. Mais de uma em cada quatro organizações atingidas por ataques maliciosos afirma que houve IA envolvida. Esses incidentes custaram, em média, cerca de US$ 1 milhão a mais do que ataques equivalentes sem IA.
Segundo — a IA da empresa virou superfície de ataque. Uma em cada cinco organizações relatou incidentes envolvendo os próprios modelos ou aplicações de IA, contra uma em oito no período anterior. E 92% desses casos ocorreram em ambientes sem controle de acesso baseado em papel e sem autenticação multifator.
Terceiro — o shadow AI é o vetor que mais cresce. Ferramentas de IA não aprovadas figuraram em 43% dos incidentes. Em cerca de metade deles houve perda ou comprometimento de dados. Em quatro de cada dez, houve interrupção operacional. E aproximadamente um em cada cinco resultou em multa regulatória.
Some a isso o indicador que atravessa todo o relatório: 247 dias, em média, para identificar e conter uma violação — a primeira interrupção em cinco anos de queda desse número.
Por que o shadow AI é diferente de shadow IT
Shadow IT sempre existiu. Um time contrata uma ferramenta sem passar pela TI, e o risco fica restrito àquela ferramenta.
Com IA, a natureza do risco muda: o dado é enviado. Contrato colado para revisão, planilha de clientes anexada para análise, trecho de código proprietário submetido para depuração. O vazamento não acontece por invasão — acontece por uso.
E o dado, uma vez enviado, passa a responder à jurisdição e à política de retenção de quem opera o modelo. Não à sua.
Foi por isso que a LGPD entrou nessa conversa antes que a maioria das empresas percebesse.
O que fazer com isso na prática
Proibir não funciona — a ferramenta simplesmente sai do radar e o uso continua no celular pessoal. O caminho é reduzir a distância entre o que é permitido e o que é necessário:
- Mapear o uso real antes de escrever política. Política escrita sobre suposição não é cumprida.
- Definir o que nunca sai do ambiente: dado pessoal de cliente, credencial, código proprietário, informação sob contrato de confidencialidade.
- Aplicar RBAC e MFA nas aplicações de IA com o mesmo rigor aplicado a qualquer sistema crítico — foi exatamente essa ausência que apareceu em 92% dos incidentes.
- Registrar acesso e retenção. Sem log, não há investigação nem defesa em auditoria.
- Reduzir o tempo de detecção. Com 247 dias de média, qualquer ganho aqui vale mais do que uma ferramenta nova.
O ponto de infraestrutura
Boa parte dessa discussão termina em uma decisão de arquitetura: onde o processamento acontece e sob qual jurisdição o dado permanece.
Ambiente dedicado, controle de acesso por camada, registro de tráfego, política de retenção definida e infraestrutura em território brasileiro não resolvem governança de IA sozinhos. Mas sem eles, nenhuma política de IA é auditável.
Na OPEN, essa base é o padrão da operação gerenciada — infraestrutura própria no Brasil, suporte especializado 24/7 e SLA com penalidade contratual.
Ferramenta nova exige governança nova. O que não muda é a necessidade de saber onde o dado está.
Sua empresa sabe quais ferramentas de IA estão em uso agora — ou apenas quais foram aprovadas?
#InteligênciaArtificial #ShadowAI #Cibersegurança #LGPD #GovernançaDeDados #GestãoDeTI #OPENDatacenter